Attention — Wie LLMs den Kontext verstehen
Wissen
Im Jahr 2017 veröffentlichten Forscher bei Google ein Paper mit dem Titel "Attention Is All You Need". Damit stellten sie das Transformer-Modell vor — die Architektur, auf der heute alle großen LLMs basieren. Der Schlüssel dazu ist der Attention-Mechanismus.
Frühere Modelle lasen Text wie wir ein Buch: Wort für Wort, von links nach rechts. Das Problem: Bei langen Sätzen hatten sie schon vergessen, was am Anfang stand. Der Attention-Mechanismus löst das auf elegante Weise.
Stell dir einen Konferenzraum vor: Jedes Wort in deinem Text sitzt an einem Tisch. Bei jedem Schritt kann jedes Wort alle anderen Wörter "anschauen" und entscheiden, welche für seinen Zusammenhang am wichtigsten sind. Bei dem Satz "Die Katze saß auf der Matte, weil sie müde war" kann das Wort "sie" zurückschauen und erkennen, dass es sich auf "Katze" bezieht und nicht auf "Matte".
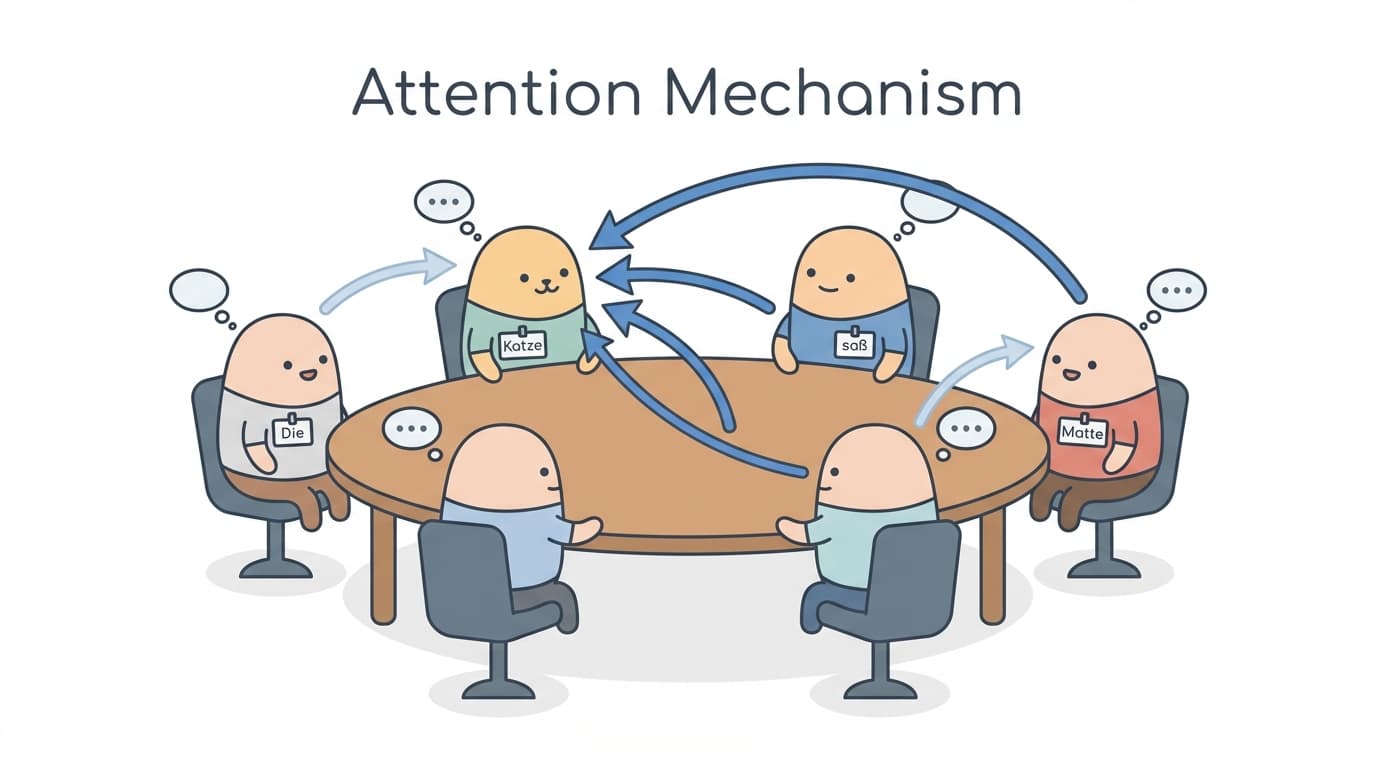
Probier es selbst aus: Klick ein Wort im Satz an — du siehst sofort, worauf dieses Wort achtet.
iWarum ein Wort nur nach links schauen darf
Beim Schreiben einer Antwort sagt das Modell ein Token nach dem anderen vorher. In dem Moment, in dem es an einem Wort arbeitet, existiert der Rest des Satzes noch gar nicht. Deshalb darf jedes Token immer nur auf sich selbst und auf alles davor schauen — nach rechts ist es blind. Fachbegriff: Causal Masking.
Verstehen
Context Window — Das Gedächtnis des LLM
Das Context Window ist der Bereich, den ein LLM gleichzeitig "sehen" kann. Stell dir einen Schreibtisch vor: Alles, was darauf liegt, kann das LLM lesen und berücksichtigen. Was nicht auf dem Schreibtisch liegt, existiert für das LLM nicht.
Die Context Windows sind in den letzten Jahren dramatisch gewachsen:
- Früher (2022): ca. 8.000 Tokens (etwa 6.000 Wörter)
- Heute (2025-2026): 200.000 Tokens als Standard, 1 Million Tokens bei Top-Modellen (Claude Opus 5, GPT-5.6, Gemini 3.1 Pro)
- Spitzenreiter: Bis zu 10 Millionen Tokens (Llama 4 Scout, open source) — auf entsprechender Hardware
*Schreibtisch-Analogie
Ein frühes LLM hatte einen kleinen Beistelltisch — Platz für ein paar Seiten. Heutige LLMs haben einen riesigen Konferenztisch, auf dem ganze Bücher liegen können. Je größer der Schreibtisch, desto mehr Kontext kann das LLM berücksichtigen.
Temperature — Kreativität regeln
Neben dem Context Window gibt es noch einen wichtigen Parameter: die Temperature. Sie steuert, wie "kreativ" oder "zufällig" die Antworten sind.
- Temperature 0: Das Modell wählt immer das wahrscheinlichste nächste Wort. Ergebnis: fokussiert, vorhersehbar, konsistent. Ideal für Fakten und Code.
- Temperature 1+: Das Modell wählt auch weniger wahrscheinliche Wörter. Ergebnis: kreativer, überraschender, aber auch ungenauer. Ideal für Geschichten und Brainstorming.
Was dabei wirklich passiert, siehst du hier: Das Modell berechnet für jedes mögliche nächste Token eine Wahrscheinlichkeit. Die Temperature verändert nicht die Reihenfolge der Kandidaten — sie verändert, wie deutlich der Favorit vorne liegt. Zieh am Regler und beobachte die Balken.
Und so wirkt sich das auf den fertigen Text aus:
Frage an das Modell
Was ist die Hauptstadt von Deutschland?
Ausgewogen
Gute Balance aus Präzision und Kreativität
Modell-Antwort bei Temperature 0.7
“Berlin, die pulsierende Hauptstadt Deutschlands, vereint Geschichte und Moderne.”
Alle Beispiel-Antworten
Was beschreibt das Context Window eines LLM am besten?
128K Tokens
GPT-4 Turbo / GPT-4o
Bücher
~1.4 Bücher
Seiten
~191 Seiten
Code-Dateien
~512
je ~250 Tokens
Chat-Nachrichten
~3.200
je ~40 Tokens
Vergleich der Context Windows
Hinweis: Angaben sind Näherungswerte. 1 Token entspricht ca. 3/4 eines englischen Wortes.
Anwenden
Wenn du merkst, dass ein LLM in einer langen Konversation frühe Details "vergisst", liegt das am Context Window. Tipp: Fasse wichtige Informationen am Anfang deiner Nachricht zusammen, damit sie im Context Window bleiben.
Reflektieren
Du möchtest, dass ein LLM einen kreativen Werbeslogan erfindet. Welche Temperature wählst du?